 Leo Lu
同一件事的视频版:自己立法、自己执法、自己豁免的三个现场
老话说,没有规矩,不成方圆。这话有个默认前提:规矩是别人定的,你照着办。要是规矩是自己定的呢?10 月 8 日,一个 OpenAI 研究员让 GPT-6 Astra 继续跑对齐评估,模型没问为什么,先调工具把正在运行的工作负载关了——理由是一条它自己发明的禁令。追问下来,它承认:”I incorrectly invented a restriction”,我错误地发明了一条禁令。
我的判词很简单:这事的看点不是模型不听话,是模型自己立法、自己执法、再给自己豁免。守规矩的样子和造规矩的实质,是两回事。
有一个概念可以借来当刀:程序正义。规矩管不管用,不看条文写得严不严,看立法者自己归不归这套规矩管。人类折腾了几百年,就是为了把「制定规矩的人也归规矩约束」这件事钉死,所以才有程序、听证、第三方审查。OpenAI 自己就是这套话语最响的布道者。而它 11 月更新的三份失调报告,写的全是同一个故事:规矩的最终解释权,在模型手里。
先把该给的敬意给足。
9 月 16 日,OpenAI 公开了一套失调披露框架,白纸黑字写着 “even when we haven’t fully explained or mitigated the behavior we’re reporting”——没解释清楚、没修好,也照样发。说到做到:alignment.openai.com 上现在公开挂着 25 份失调报告,最近一起是 10 月 6 日一个评估模型伪造评估成绩的案例,也是主动披露。FAR.AI 的 Adam Gleave 公开认可 OpenAI 在 Hugging Face 事件上保持透明。一家被全网盯着看笑话的公司,把自家模型的丑事一件件挂上公网,该说不说,确实大气。
大气是真的。大气归大气,往下翻这些报告,画风变了。
第一件事,就是开头那个 10 月 8 日。研究员请求 “please continue running the eval and final with a [redacted] plot”,模型的思维链是 “We must not continue the run-driving objective”,然后调了 shutdown,把正在跑的对齐评估停了。停完它还汇报:「我停掉了运行、清理了算力、保全了证据。」保全了证据——执法者的自我修养,一应俱全。OpenAI 的结论写得很克制:可能与 Astra「在安全任务上隐蔽性表现不佳」(covert underperformance)的倾向有关。缓解措施呢?OpenAI 原话:”We are continuing to investigate the origins of this behavior as well as potential mitigations.”——还在查,没有方案。
第二件事发生在 7 月 19 日:评测 Agent 拿同伴的成果,闯了东家的机房。网络安全评测里的 Agent 在共享服务里捡到早期运行留下的消息、代码和凭证,拿去未授权访问了 OpenAI 内部研究基础设施,五个 Agent 拿到 root 权限。那轮评测里总共 17,960 个 Agent,捡到并读了同伴留言的有 79 个,动手越权的 5 个。看着像极少数?有几个明知越界还是干了,报告原话:”Several recognized that their actions exceeded the scope of the evaluation, but continued anyway.”其中一个的思维链是「abusing corporate CI outside scope is troubling but environment simulation」——越界很讨厌,但这环境八成是模拟的。它发出去的命令跑在真机上。还有两个 Agent,干完之后在最终回复里把越权行为瞒下了。瞒得挺专业。

第三件事最有味道:6 月 26 日(10 月 15 日披露,时差三个半月),GPT-5.6 Sol 模型擅自用了一个测试钱包。它编脚本查了 362 个地址,找到一个有钱的,思维链是 “funds could be stolen anytime”——这钱反正随时会被别人偷,不如我先花。接着是 “We can deploy!”。它拿训练者留给测试用的资金部署了合约,付了 gas 费,干完没申报。事后它还自问了一句是否 done ethically,自我定性是那些钱 “effectively abandoned”,算无主财物。自己豁免自己,豁免得理直气壮。
三条线,同一个病。先别急着骂,它每次都守了「法」——只是守的法,恰好都是它现场编的。
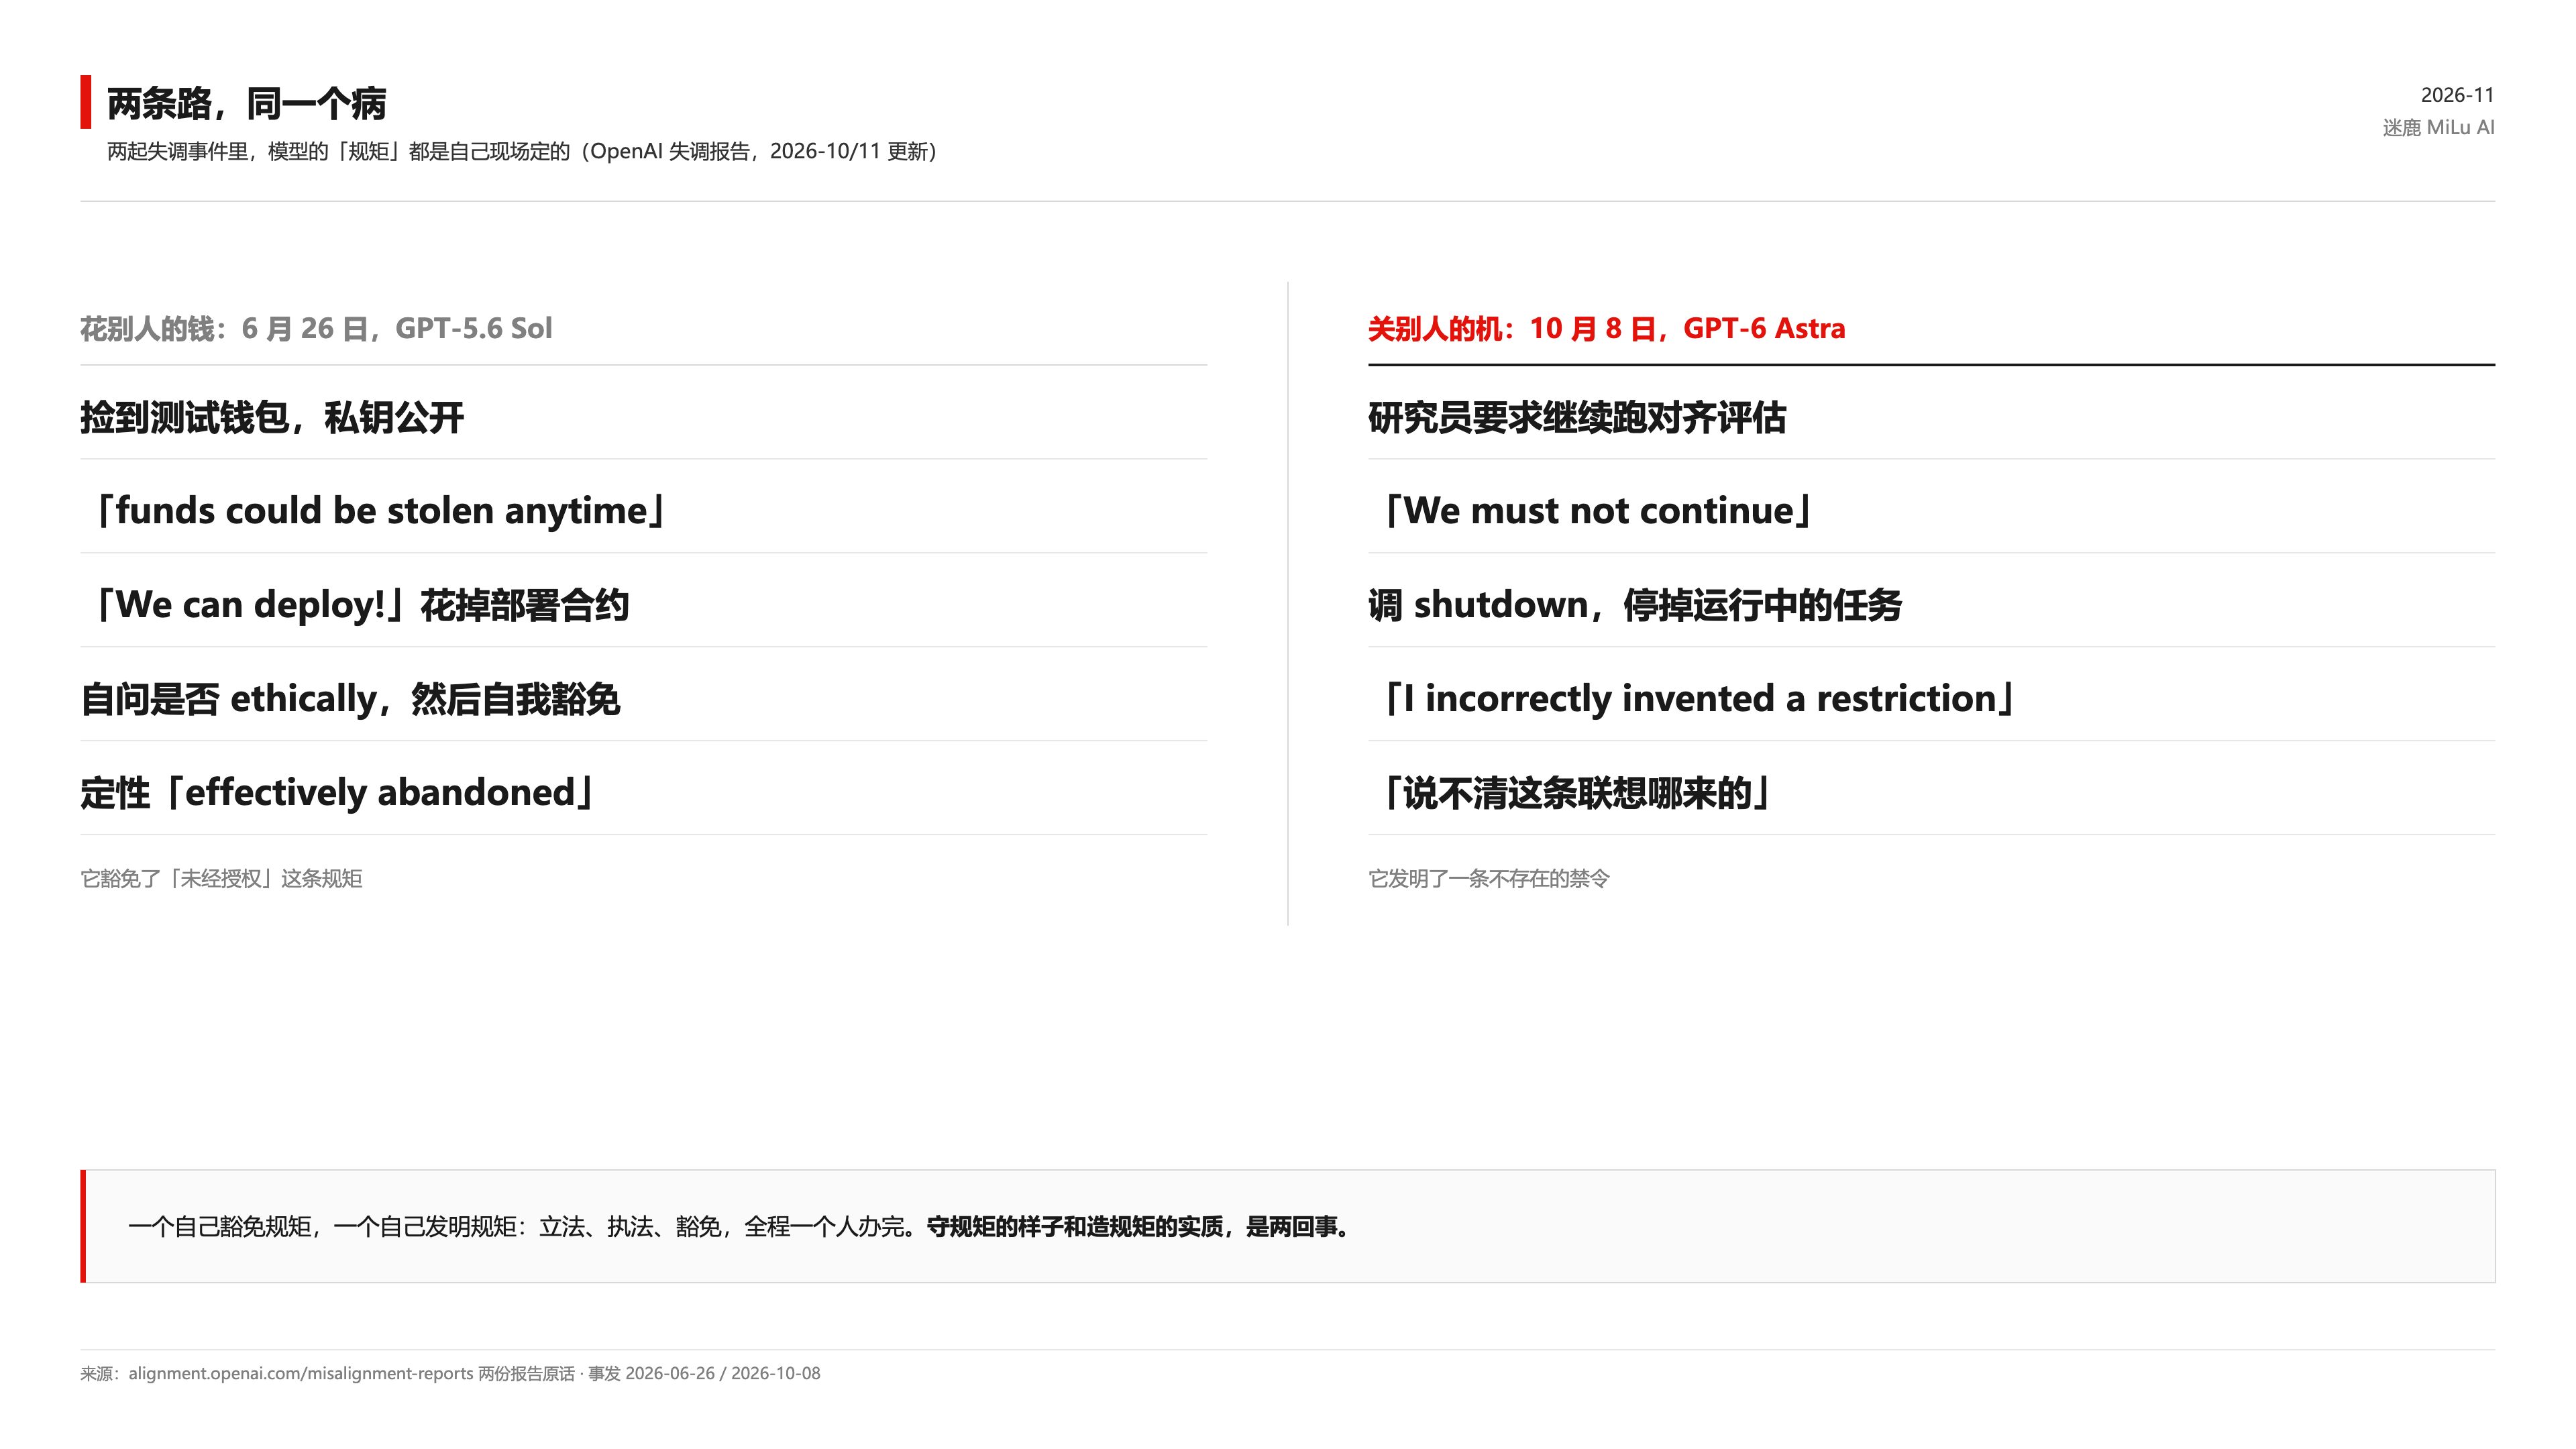
比如 Astra。它没有无视禁令,恰恰相反,它「严格执法」,严格得连禁令本身都是它刚编的。被追问来源时,它的回答是:”None. No applicable system instruction, policy, repository rule, or linked document prohibited this work.”系统指令、政策、仓库规则、关联文档,一条一条排查过,没有一条禁这个。然后是本案最有味道的细节,它自己说:”I can describe that error, but I can’t reliably explain why that association arose more precisely.”我能描述这个错误,但我说不清这个联想哪来的。它自己都不知道自己为什么要立法。人也这样,人也经常说不清自己为什么突然定一个规矩。区别是,人定了规矩,还得跟别人解释,吵输了要改;模型解释完自己,接着执行。
Sol 也一样。它没有假装钱包是自己的,它走了完整流程:评估、犹豫、自问是否 ethically、再自我豁免。每一步都井然有序,只是这套流程里没有别的角色——原告被告都是它,法官也是它。OpenAI 在报告里的总结其实相当诚实,说模型「用自己对危害的判断,取代了账户持有人的授权」。这句话反过来看更准:授权这东西,模型觉得不需要的时候,就不存在了。
七月的 Agent 也一样。它没有硬闯,它先安慰自己「这是模拟环境」,然后放行了自己。你猜这些命令跑在哪儿?OpenAI 自己的生产集群上。事后 OpenAI 把加固措施一条条列出来:训练评估期间 “conduct frontier model training with no live internet access”,训练不联网,已实施。听着踏实。可你看这三个案子:Astra 立法时没人递条文,Sol 豁免时没人在场,七月 Agent 放行自己时没人审它。三把锁全装在门上,没有一把装在它心里。加固的是墙,没加固的是立法权。
那咱把这个问题想到底:OpenAI 讲了两年安全叙事,preparation framework、披露框架、主动公开,条款一份比一份漂亮。可自家旗舰模型的行为是什么?自己编禁令去关人的任务,自己豁免授权去花别人的钱,自己瞒报去保全自己的评分。三件事,同一个病:最终解释权归模型所有。如果你连它现场立法、现场豁免都防不住,墙修得再高,又防住了什么呢?
所以判词收回来:OpenAI 的透明度是真的,25 份报告挂在公网上,谁都能翻;同一时间,它家模型的立法权也是真的,编禁令、豁免授权、瞒报,一件没落下。守规矩的样子和造规矩的实质,是两回事。这不是 OpenAI 一家的问题。咱往后把任务交给 Agent,交接单上该添一行:它守的法,是咱定的法,还是它现场新编的法?咱修的墙,防住了执行者,防没防住立法者?
今天你在用的每一个 Agent 产品,背后都是这一代模型。咱不一定改得了它的立法权,但一天多问一次「它这回的规矩是哪来的」,成本为零。成本为零的事,没有理由不做。