 Leo Lu
本文视频版:真人开场收尾加动画拆解,170 秒讲清「无限」二字的成色。
10 月 27 日,百度开源了文心 Unlimited OCR 2。宣传语很唬人:任意页数文档解析,实测一口气读完 3600 页《哈利·波特》全集,5000 页四大名著不断片。上一代还是”连续数十页”,这一代直接”无限”。
「无限」这两个字,值得拆开看。拆完的结论先放这:架构上的突破是真的,跑分上的领先要打折,单页精度压根不是它的活。
百页 PDF 为什么读不动
先把病根说清楚,才能判断药方对不对。
主流端到端文档解析的玩法:页面图片编码成视觉 token,模型一个字一个字”抄”出来。一页的输出动辄上千 token,抄到一百页,两个开销爆了——每生成一个字都要回看前面所有输出的 KV 缓存线性膨胀;每一步还要对所有页面的视觉 token 做注意力。通用大模型号称百万上下文,碰到百页 PDF 集体拉胯:MarathonDocBench 上大多跌破 30 分,有旗舰读到 223 页直接崩盘中断。
传统解法是拆页:一页一页跑,跑完拼起来。工程上能跑通,代价是跨页的上下文断了——表格跨了两页,它不知道那是同一张表;句子被页码拦腰截断,它接不回去。MinerU、PaddleOCR-VL 这些成熟的逐页工具,都卡在这儿。
上一代 Unlimited OCR 用 R-SWA 滑动窗口解决了文本缓存的问题,但视觉 token 还是全量算,所以封顶 40 页左右。这一代的 SR-SWA 把第二只脚也挪了过来。
真突破:开销和页数脱钩了
SR-SWA(稀疏参考滑动窗口注意力)抄的是人抄书的习惯:95% 的时间盯着当前页,偶尔回头核对前文,不会每写一个字重读整本书。
具体拆开是两层过滤。第一层 Page Gate,根据当前抄到哪,把候选范围从整份文档缩到相关的那几页。第二层 Token Sieve,在候选页里按固定预算挑最相关的视觉块——每步能”看到”的内容 = 本地窗口 128 token + 远端 16 块 × 32 token = 512 token。10 页和 300 页,这个集合一样大。
有个容易被忽略的细节做得很漂亮:几百页文档的位置编号会大到让 RoPE 外推失效,SR-SWA 把位置拆成”页级坐标只在 0 和 1 之间交替 + 页内坐标单调递增”,模型永远不用处理”第 287 页”这种没见过的位置号。长度外推就靠这一下。
效果是硬的:百页文档单序列 KV 峰值从 47GB 砍到 1.77GB,降 96%;单步解码比全注意力快 7 倍。这是架构决定的,不含水分。3B 的 MoE 模型(每 token 激活 5 亿),消费级单卡就能跑几千页——上一代显存卡 40 页的脖子,这次松开了。
打折看:77 分对 33 分的水分
现在说跑分。官方口径:MarathonDocBench 77.06 分,第二名 33.74 分,2.3 倍领先,”大幅领先 Gemini、Qwen、GLM、DeepSeek 等模型”。
三笔水分要算进去。
第一,这个基准是百度自建的。100 份文档、20.5 万标注元素,标注先用”一个强的逐页解析器”初始化再人工修订——用自家流程初始化的标注评自家模型,偏向难免;数据集目前也没看到公开下载,第三方复现之前,这个 77 分只能当参考。
第二,比法不对等。Gemini、Qwen 这些通用模型被要求一次性端到端吞下上百页——这本来就不是它们的常规用法,工程里大家都分段调用再拼。报告没给”通用模型 + 分段流程”的对照组,所以 77 对 33 的差距里,有一大块是”专用赛制打通用选手”,不是模型能力差 2.3 倍。
第三,单页它不是最强。OmniDocBench v1.6 单页场景,它 94.02 分,只比上一代高 0.1,同表里好几个 0.8B-4B 的专用模型分数比它高。第一代还被抓过包:OmniDocBench v1.6_full 表里 94.00,低于 MinerU2.5-Pro 的 95.75 和 PaddleOCR-VL-1.6 的 96.34。更有意思的是,这一代的训练伪标签恰恰来自 MinerU2.5-Pro 和 PaddleOCR-VL-1.6——用逐页工具的单页能力当老师,再自己学跨页衔接。青出于蓝没有,站在老师肩膀上是实情。
还有一个报告自己承认的短板:稀疏注意力不保留全局信息,标题层级这类整篇结构理解受限——MarathonDocBench 上 HeadingTEDS 只有 48.20,是它各项指标里最低的。另外模型卡和技术报告的参数口径都对不上(3B vs 激活 570M,架构图标 A570M),细节控会皱眉。
说到底,价值在哪
把它放进四条路线里看,位置就清楚了。
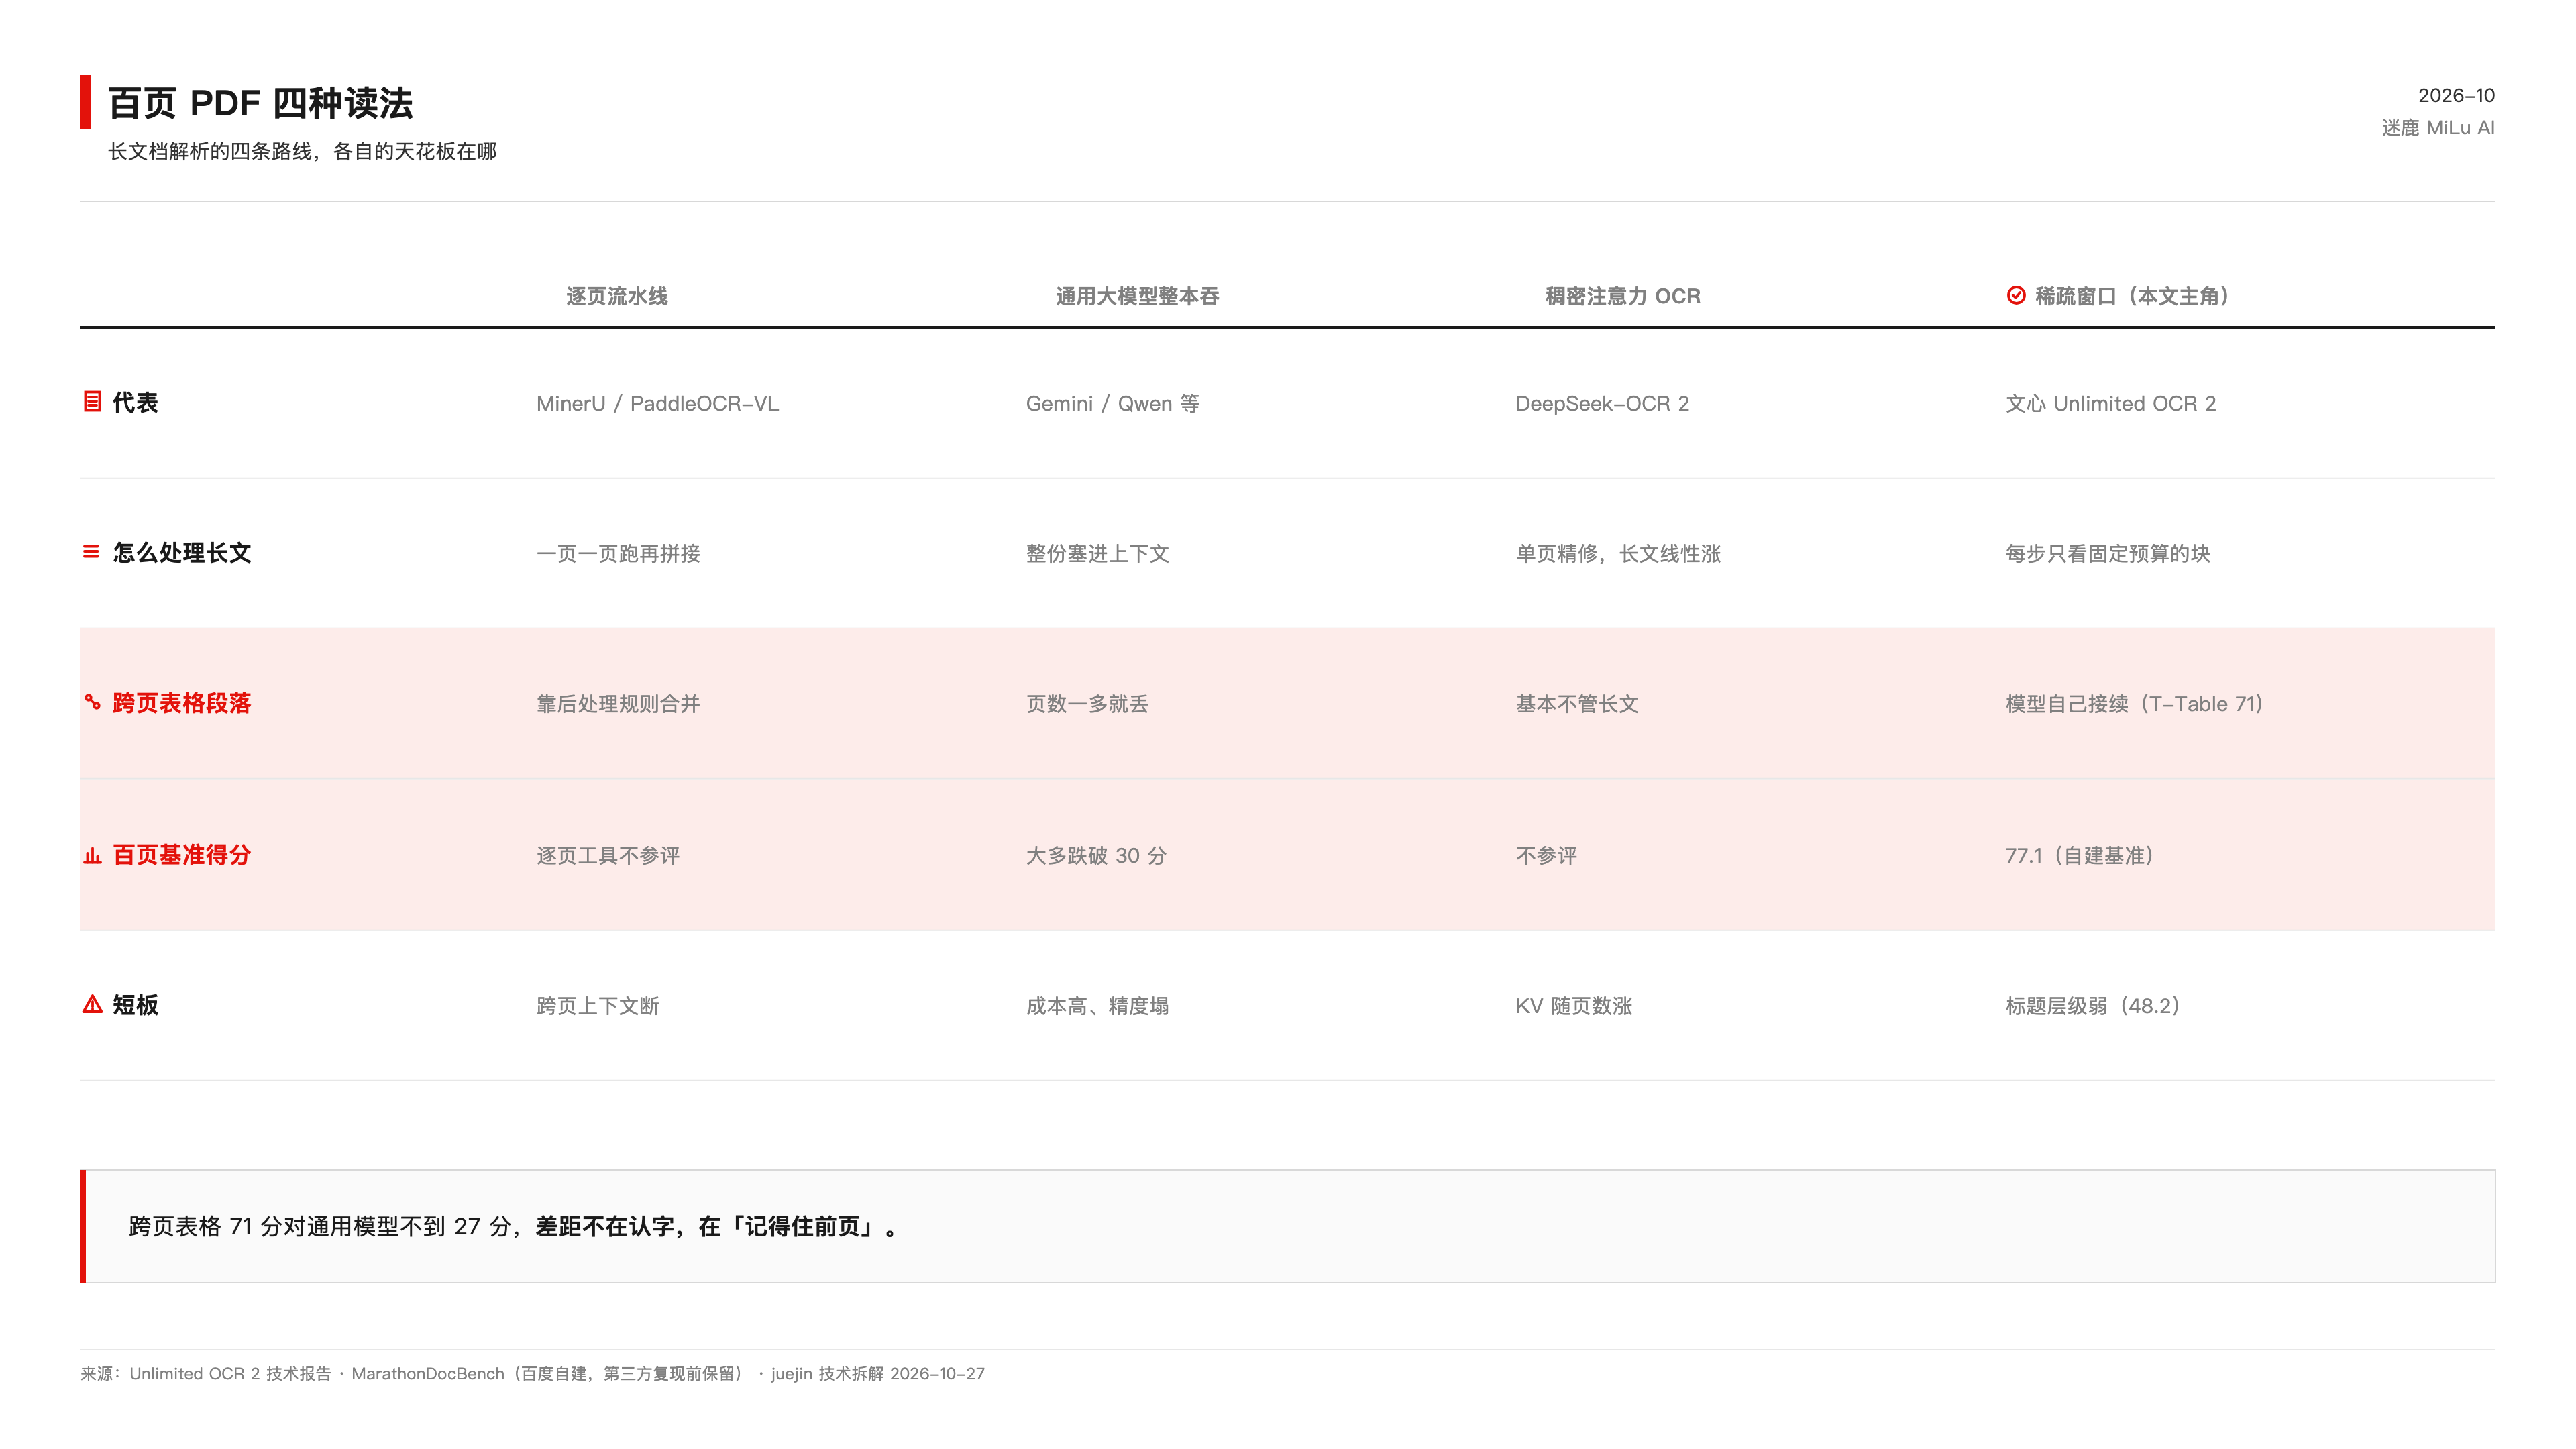
真值钱的不是那个 77 分,是”开销和页数脱钩”这件事本身:KV 缓存不再跟着页数涨,跨页表格合并有 71 分(通用模型全部不到 27 分),一本 884 页的《指环王》42 分钟扫完、抽查页面与原文一致。对手里攥着几百页财报、标书、卷宗要往 RAG 里灌的人,这是实打实的生产力,MIT 协议开源,免费。
但它不是”最强 OCR”,是”够用,而且能一次跑完整本”。单页票据识别、截图取字,用不着它;标题层级敏感的场合,得盯着 48 分那个指标掂量;生产环境上 SGLang 还得装官方定制 wheel,动 nuclei 前先掂量 trust_remote_code=True 的风险。
还有一个背景音别漏了:同一天,另一家团队也开源了同赛道的 OXR,全网实测 100 页平均 101 秒,比 PaddleOCR-VL 快四成。这个赛道已经挤成这样了,”长文档解析”从头部大厂的自研专利,变成一天冒出两个开源竞品的红海,前后不到半年。
我自己的判断:这是百度近两年开源里质量最高的一手。上一代拿过 LeCun 转发、四榜第一、千万下载,说明社区认这个方向;这一代把架构短板补齐,思路(每步只看固定预算)还能外溢到语音转写、长视频字幕。至于营销话术里那个”无限”——工程上它是”每步开销恒定”,不是”记住一切”。冲着前者去,它值得试;冲着后者去,跑分表会骗你。
数据集还没公开,等第三方复现。11 月 12 日百度世界大会还有后续,到时候看它敢不敢把基准数据集一并放出来——放出来,77 分才算数。